Waarom The Times zo goed scoort in Google Discover

Een data- en techniekanalyse op basis van een jaar Discover-vermeldingen (GB) en live onderzoek
TL;DR | de belangrijkste bevindingen
Methodologie: analyse gebaseerd op een DiscoverSnoop-export voor de UK (1.721 Discover-vermeldingen, 29 juli 2025 – 28 juli 2026, ca. 70% van het totale Discover-volume van The Times), aangevuld met live onderzoek.
Waarom dit onderzoek?
De aanleiding voor dit onderzoek was een artikel van Press Gazette waarin naar voren kwam dat The Times jaar op jaar sterke resultaten boekt . Dat maakte me nieuwsgierig: wat doet deze titel concreet goed, en is dat te herleiden tot specifieke keuzes in content, techniek of strategie? In plaats van te blijven hangen bij de constatering dat het goed gaat, wilde ik uitzoeken waar dat succes vandaan komt. Met Google Discover als een van de meetbare kanalen waarlangs dat succes zichtbaar wordt.
Manier van onderzoek
Voor dit onderzoek heb ik de volgende stappen doorlopen:
- een export van DiscoverSnoop gebruikt met alle Discover-vermeldingen van The Times (UK) over de afgelopen twaalf maanden.
- Deze ruwe export heb ik met behulp van Claude (Anthropic) omgezet naar overzichtelijke tabellen en werkbare datapunten, denk aan maandelijkse volumes, categorieverdelingen en entiteitenanalyses.
- Op basis daarvan heb ik zelf een handmatige audit uitgevoerd: ik heb losse artikelen, de robots.txt, structured data, paywall-opbouw en abonnementsaanbiedingen live bekeken en gecontroleerd, om te toetsen of de patronen uit de data ook daadwerkelijk terug te zien zijn op de site zelf.
- De uiteindelijke, doorlopende tekst van dit artikel is met hulp van Claude tot een samenhangend verhaal gemaakt op basis van mijn eigen analyse en bevindingen.
1. Volume en groei: een stijgende lijn, geen toevalstreffer
Augustus 2025 is de eerste maand met volledige dekking in de export en dient als nulpunt (juli 2025 was een gedeeltelijke maand en is daarom niet meegenomen):
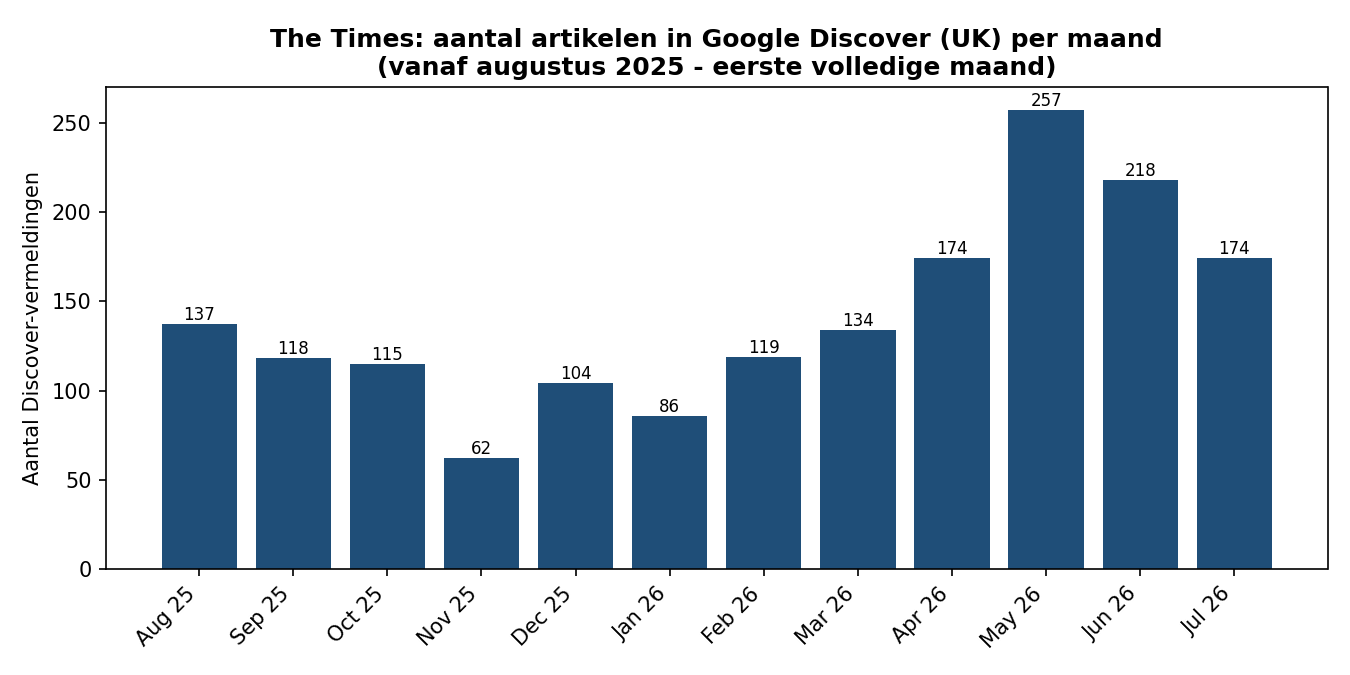
Vanaf dit startpunt (137 in augustus 2025) loopt de lijn op naar een piek van 257 in mei 2026. Een groei van circa 87%, grotendeels geleidelijk vanaf januari 2026, met een tijdelijke dip in november 2025 (62). De iets lagere cijfers in juni/juli 2026 liggen nog altijd ruim boven het niveau van een jaar eerder. Voor een subscription-site is dit een bewuste investering: Discover-traffic converteert doorgaans niet direct naar abonnees, dus de waarde zit vooral in merkbekendheid en top-of-funnel bereik.
2. Contentmix: menselijk drama en royals verslaan droog nieuws
De categorie-indeling van DiscoverSnoop laat zien waar het volume vandaan komt:
|
Categorie |
Aantal vermeldingen |
|---|---|
|
Sensitive Subjects |
99 |
|
Law & Government / Government |
84 |
|
News (algemeen) |
76 |
|
Celebrities & Entertainment News |
69 |
|
News / Politics |
60 |
|
Travel / Air Travel |
40 |
|
Soccer |
39 |
Maar kijk je naar de best scorende individuele artikelen, dan springt een patroon eruit: concrete, individuele verhalen met een herkenbaar hoofdpersonage, een bedrag of een expliciet dilemma. Enkele voorbeelden uit de top-20 van de dataset:
De entiteitenanalyse bevestigt dit op grotere schaal: na ‘Sport’ en ‘Scotland’ zijn ‘British royal family’, ‘Prince of Wales’ en ‘Duke of York’/‘Prince Andrew’ de meest voorkomende entiteiten. Een vaste, hoogfrequente ‘safe bet’-contentlijn naast de incidentele menselijke-interest-uitschieters hierboven.
3. Redactionele kracht: EEAT, transparantie en geen afleiding
Los van de Discover-cijfers valt een aantal structurele keuzes op die de site sterk maken, zowel voor gebruikerservaring als voor vertrouwenssignalen richting Google en lezers.
Auteursprofielen met concrete rol
Bylines vermelden niet alleen een naam, maar een functietitel. Bij een liveblog over de sociale-zorgtoespraak van de premier stonden bijvoorbeeld drie auteurs met expliciete rol: ‘Daisy Eastlake, Political Reporter’, ‘Eleanor Hayward, Health Editor’ en ‘Ben Clatworthy, Whitehall Editor’. Elke naam linkt door naar een profielpagina met foto, functietitel, social-handle en een beat-beschrijving die verder gaat dan een generieke bio:
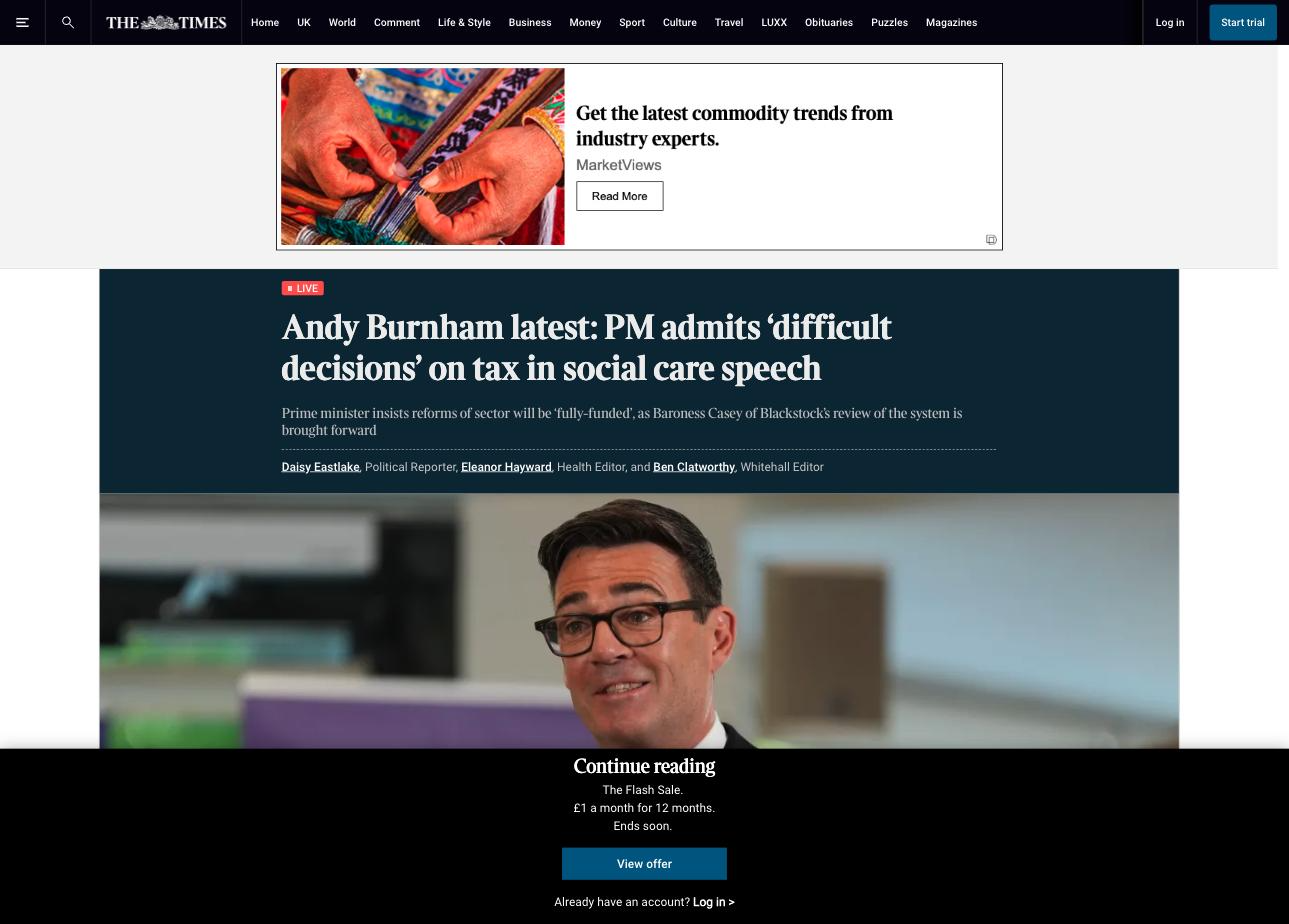
Liveblog-artikel: LIVE-badge, drie auteurs met functietitel in de byline.
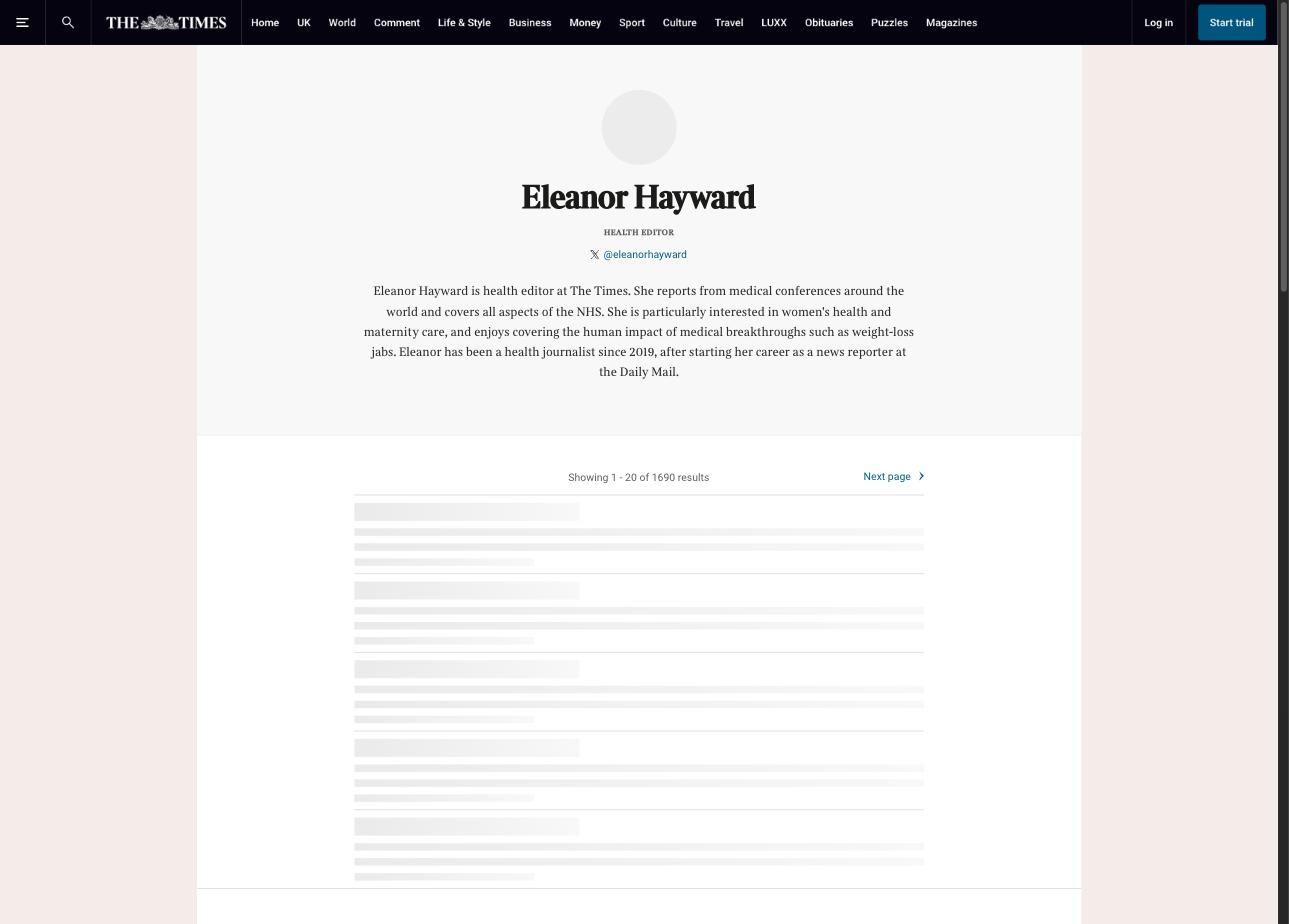
Profielpagina Eleanor Hayward: rol, beat-beschrijving, social-link en archief van 1.690 artikelen.
Live-content is onmiskenbaar gelabeld
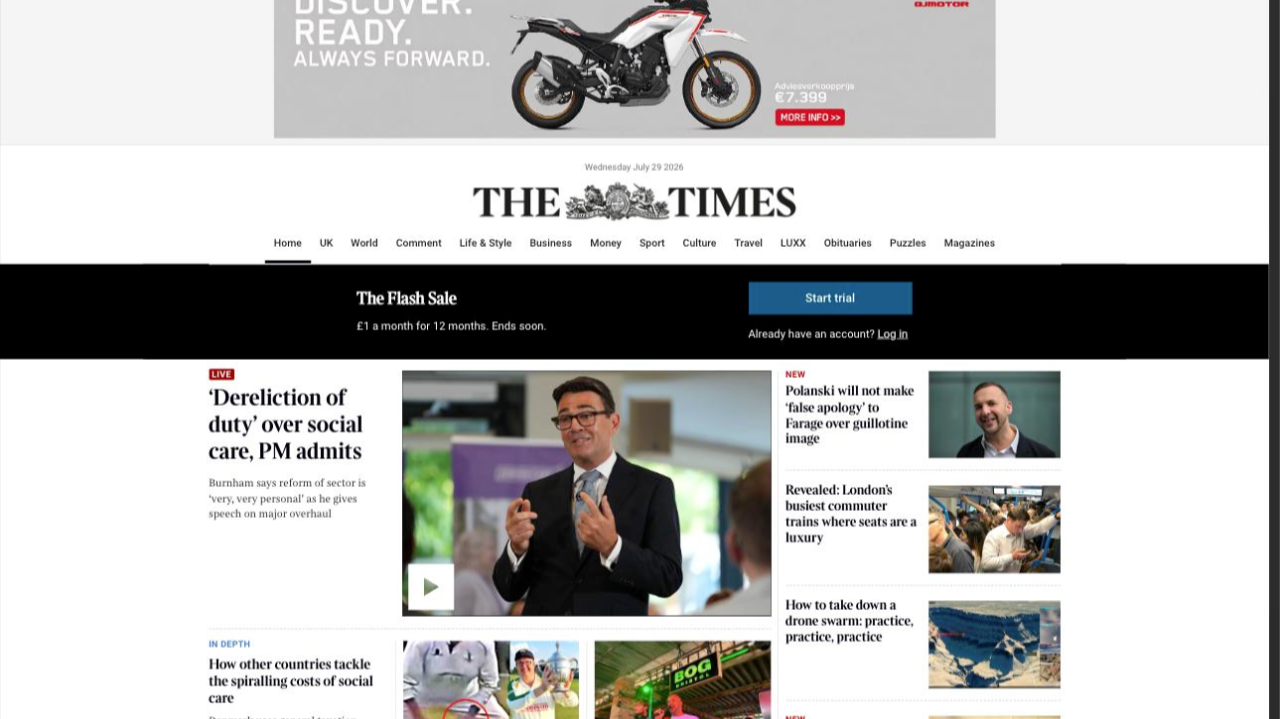
Zowel op de homepage-teaser als op de artikelpagina zelf staat een rode ‘LIVE’-badge, duidelijk visueel onderscheiden van reguliere artikelen (donkere achtergrond in plaats van wit). Onder de motorkap komt dit overeen met een apart schematype: naast NewsArticle en BreadcrumbList vonden we bij dit liveblog-artikel ook LiveBlogPosting. Dit is het juiste, specifieke schema voor dit contenttype in plaats van een generieke NewsArticle-markup.
Geen overlay-advertenties
Op geen van de zeven onderzochte artikelpagina’s en de homepage verscheen een interstitial, popup of overlay-advertentie die de content blokkeert. Enkel standaard banner-advertenties boven de vouw. Voor een site met dit advertentievolume is dat een bewuste keuze die de leeservaring (en daarmee page experience-signalen) ten goede komt.
Puzzle-sectie als aparte retentiemotor
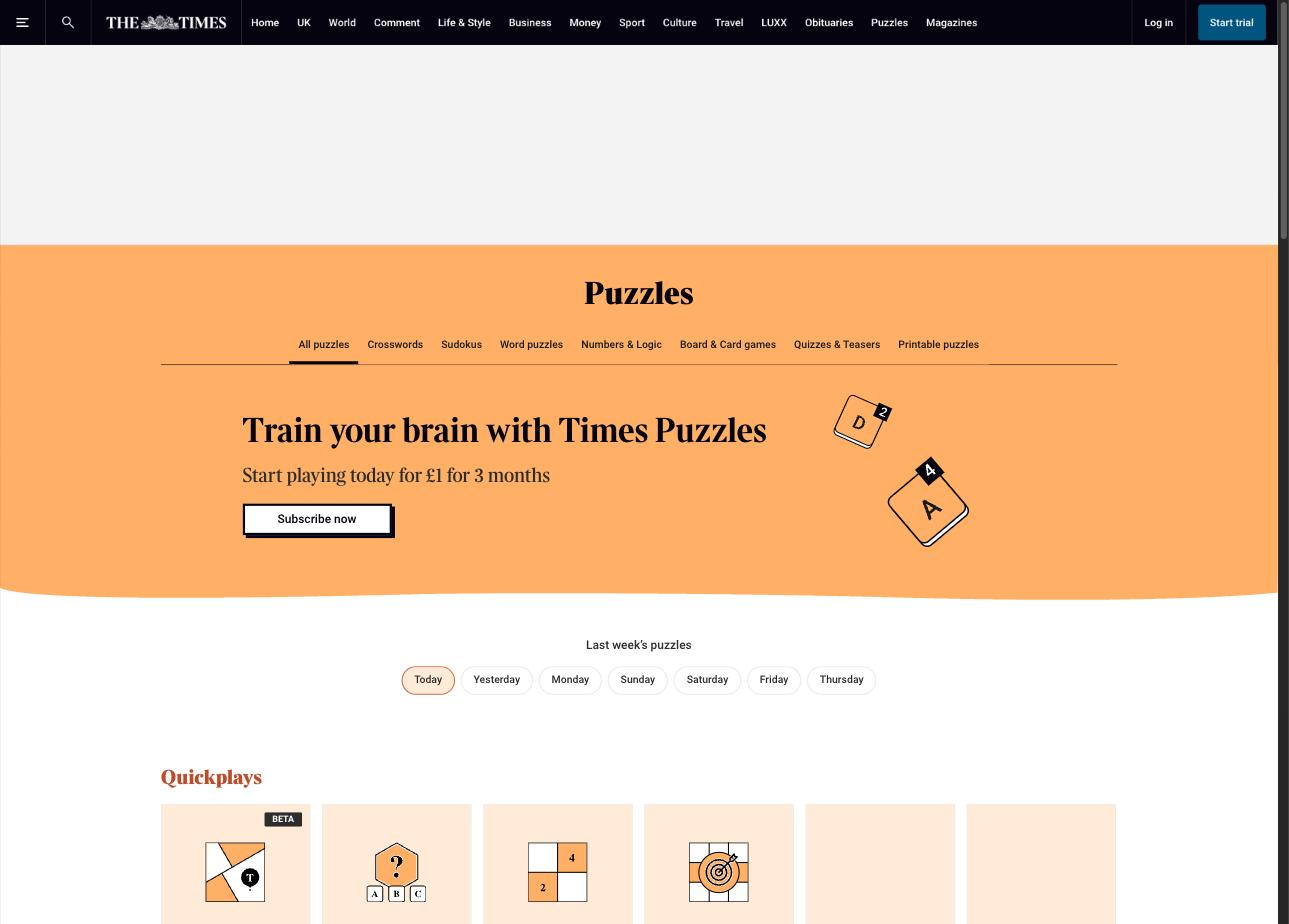
Los van nieuws en Discover heeft The Times een uitgebreide, dagelijks ververste puzzelsectie (crosswords, sudoku’s, woord- en logicapuzzels, bordspellen). Dit soort content genereert geen Discover-traffic, maar wel een reden om dagelijks direct naar de site terug te komen. Wat zorgt voor een aanvullende retentiestrategie naast de Discover-afhankelijke instroom van nieuwsartikelen.
Een gelaagd, laagdrempelig abonnementsaanbod
Opvallend is dat er niet één, maar twee verschillende instapaanbiedingen naast elkaar bestaan: het sitebrede ‘Flash Sale’-aanbod (£1 per maand voor 12 maanden, zichtbaar in de banner op elke paywalled pagina) en een apart, nog lager instapaanbod specifiek voor de Puzzles-sectie (£1 voor 3 maanden). Dat is een bewuste segmentatie: bezoekers die binnenkomen via een nieuwsartikel krijgen een ander aanbod te zien dan bezoekers die primair voor de puzzels komen.
4. Freshness en URL-strategie: hoe artikelen terugkeren in Discover
Over zeven metingen (zes artikelen, verspreid over meerdere maanden en contentsoorten) verschijnt een artikel doorgaans tussen 1,8 en 11,1 uur na publicatie in Discover. Dus dezelfde dag tot de volgende ochtend, nooit dagen later, met één belangrijke uitzondering die hieronder wordt uitgelicht.
Het sterkste en meest concrete bewijs in deze dataset voor bewuste content-recirculatie is het Dragons’ Den/Vitabiotics-artikel. Dit artikel stond eerst onder:
Live onderzoek bevestigt: deze oude URL geeft nu een 301-redirect naar een nieuwe sectie-URL met dezelfde slug:
Het artikel verhuisde dus van de sectie ‘economics’ naar ‘companies-markets’, een redactionele herclassificatie naarmate het verhaal zich ontwikkelde (van macro-economisch nieuws naar een concrete bedrijfsdeal) en kreeg daarbij een nette redirect in plaats van een dode link of duplicate content. Twee dagen na de oorspronkelijke publicatie (dateModified verschoof van 30 mei naar 1 juni) keerde het artikel terug in Discover onder de nieuwe URL, als aparte vermelding met een eigen score (5,9). Dit is een concreet, herhaalbaar mechanisme: een zichtbare sectie-/URL-migratie met correcte redirect en canonical kan een artikel opnieuw Discover-waardig maken, in plaats van dat het stilzwijgend uit de roulatie verdwijnt.
5. Techniek: schema en crawler-governance
Op paginaniveau is de technische opzet functioneel en zonder overbodige toevoegingen: standaardartikelen bevatten twee JSON-LD-blokken (NewsArticle + BreadcrumbList), liveblogs een derde (LiveBlogPosting). Geen schema-stapeling, geen overbodige FAQ- of HowTo-markup die niet bij het contenttype past.
Interessanter is robots.txt. The Times blokkeert standaard alle crawlers (‘Disallow: /’ voor User-agent: *), maar heft dit expliciet op voor een lange, specifiek samengestelde lijst: Googlebot, Bingbot, DuckDuckBot en Applebot naast SEO-tools (Screaming Frog, SemrushBot, OnCrawl) en opvallend GPTBot, ChatGPT-User en OAI-SearchBot. De toelichting in het bestand zelf is expliciet: ‘The Times does not permit the unlicensed use of our content for large language models.’ Dat impliceert dat de crawlers die wel worden toegelaten, dit zijn op basis van een licentie-afspraak, geen blanket-verbod, maar gerichte toegangscontrole per partij.

De Google News-sitemap onderschrijft de publicatiesnelheid: op het moment van onderzoek bevatte de sitemap 337 artikelen binnen een venster van ongeveer 48 uur gemiddeld zo’n 168 nieuwe of bijgewerkte artikelen per dag sitebreed.
6. Paywall en kopstrategie: de titel moet twee keer verkopen
Bij het bezoeken van een artikelpagina is de content vrijwel direct afgeschermd: na de kop en een lead-in van één zin volgt meteen het abonnementsblok.
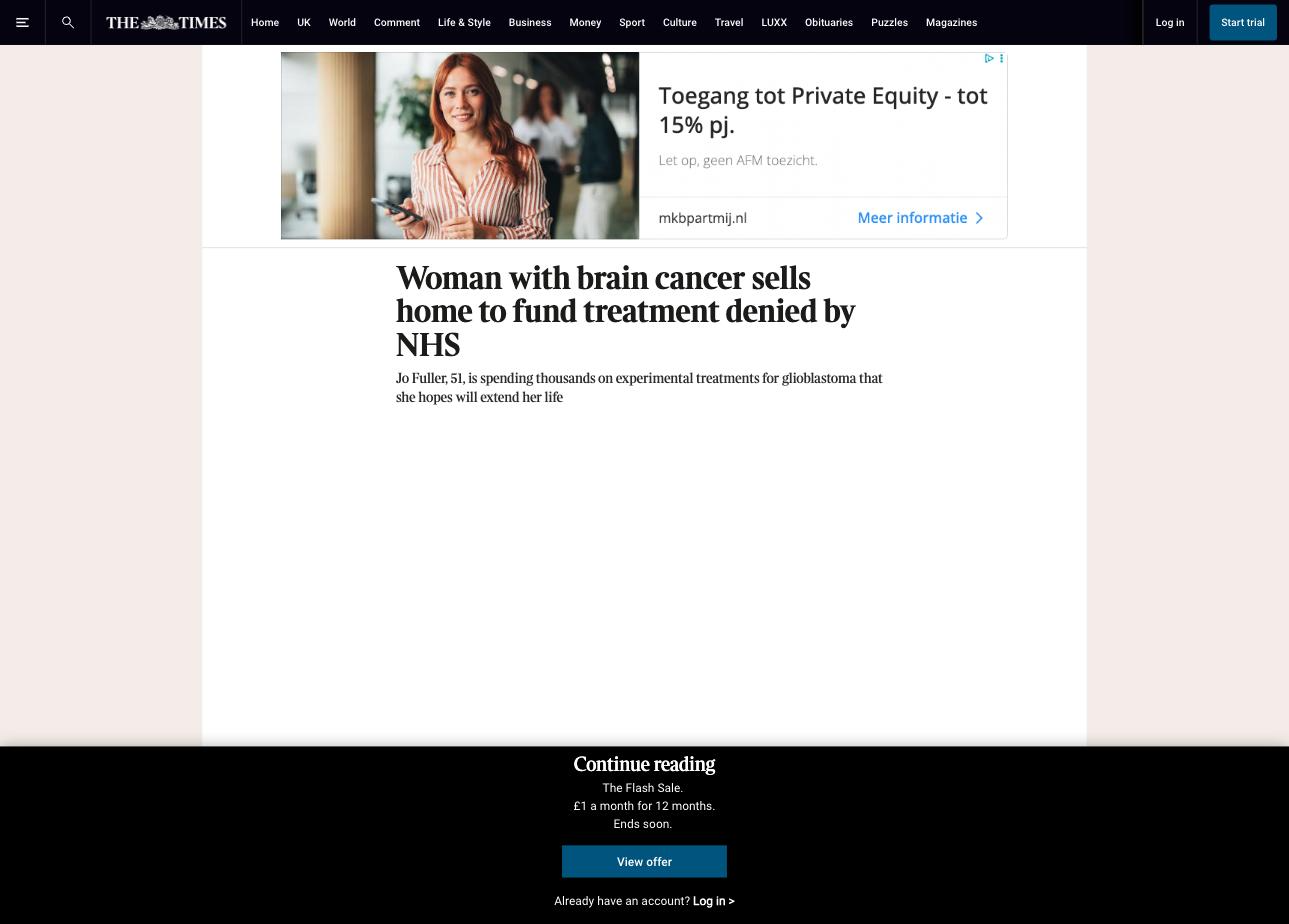
Artikelpagina direct achter de cookie-wall: kop en standfirst zijn het enige gratis zichtbare tekstelement
Dit betekent dat titel en standfirst een dubbele rol vervullen: ze moeten de Discover-klik verdienen en de nieuwsgierigheid opwekken die tot een proefabonnement leidt. Dat verklaart mede waarom veel topscorende koppen zo geconstrueerd zijn rond een concreet mens, een concreet bedrag of een concrete uitkomst. Specificiteit werkt zowel als Discover-hook als conversieprikkel.
Concrete adviezen voor publishers
Onderstaande adviezen zijn direct afgeleid van bovenstaande bevindingen en zijn generiek toepasbaar op andere nieuws- of contentsites, niet alleen op The Times zelf.
Disclaimer: Claude is gebruikt voor data-extractie uit de DiscoverSnoop-export en voor het verwerken van mijn bevindingen tot een doorlopend verhaal. Analyse, interpretatie en conclusies zijn gebaseerd op eigen, handmatig uitgevoerde controles op de website van The Times.