Blijf je Meta gebruiken, dan mag Meta je journalistiek gebruiken

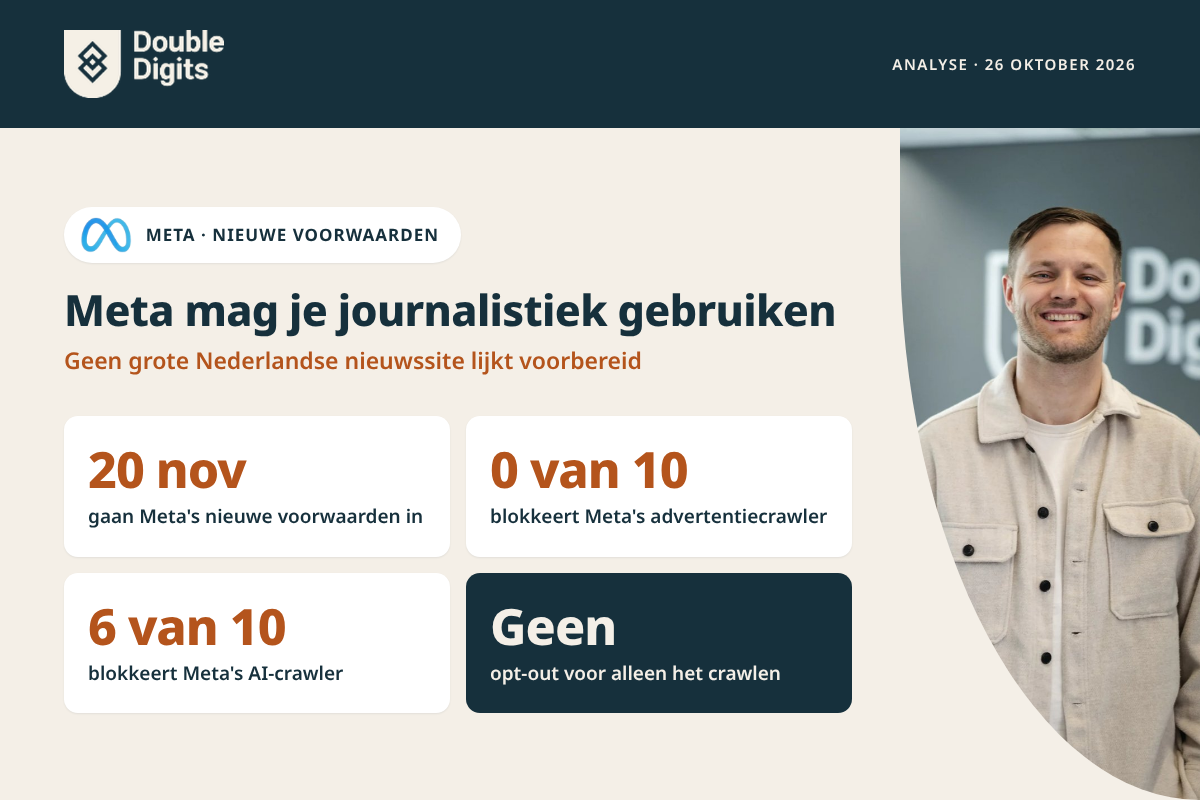
0 van de 10 grote Nederlandse nieuwssites lijkt voorbereid op Meta’s nieuwe voorwaarden.
In één oogopslag
Hieronder lees je wat er verandert, wat dat voor jou betekent en wat je kunt doen. De technische uitwerking voor je developer staat apart, onderaan.
1. Wat gaat er gebeuren
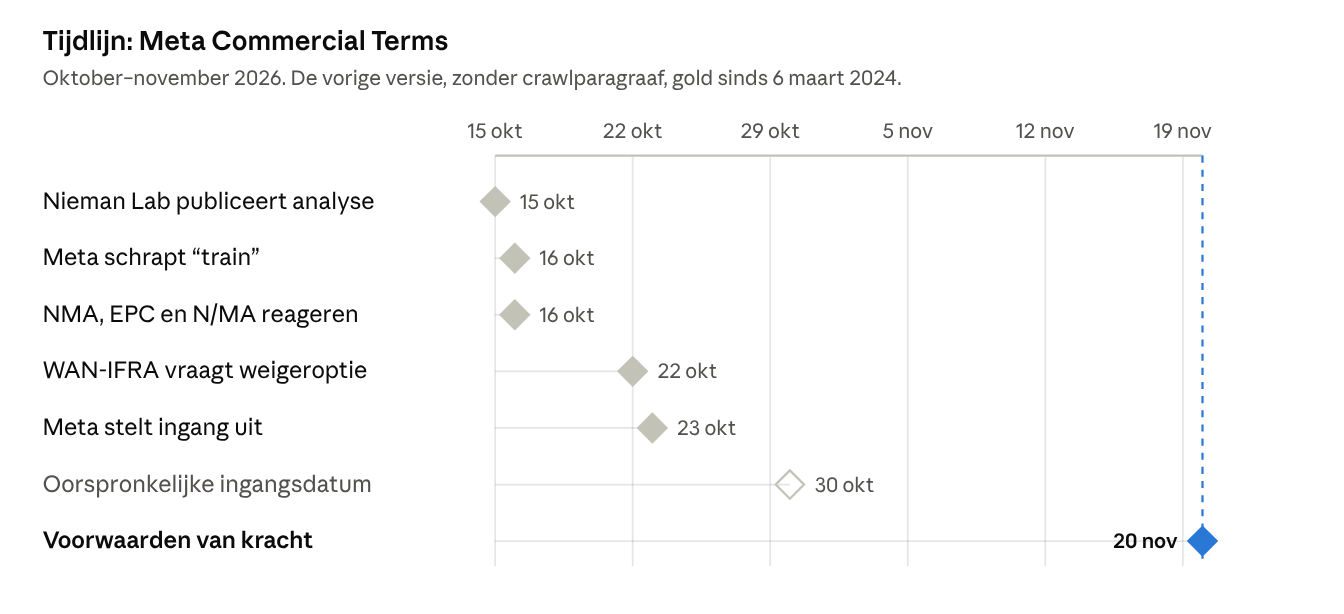
Op 20 november gaan nieuwe Commercial Terms van Meta in. Daarin staat een nieuwe alinea waarmee je Meta toestemming geeft om je website automatisch te crawlen. In de vorige versie, van 6 maart 2024, stond zo’n alinea niet.
De voorwaarden zouden eerst op 30 oktober ingaan. Op 23 oktober stelde Meta dat uit naar 20 november, om “more time” te hebben om partners uit te leggen “what’s changing and what’s not” (The Keyword, via Reuters). De tekst zelf is daarbij niet herschreven (PPC Land).
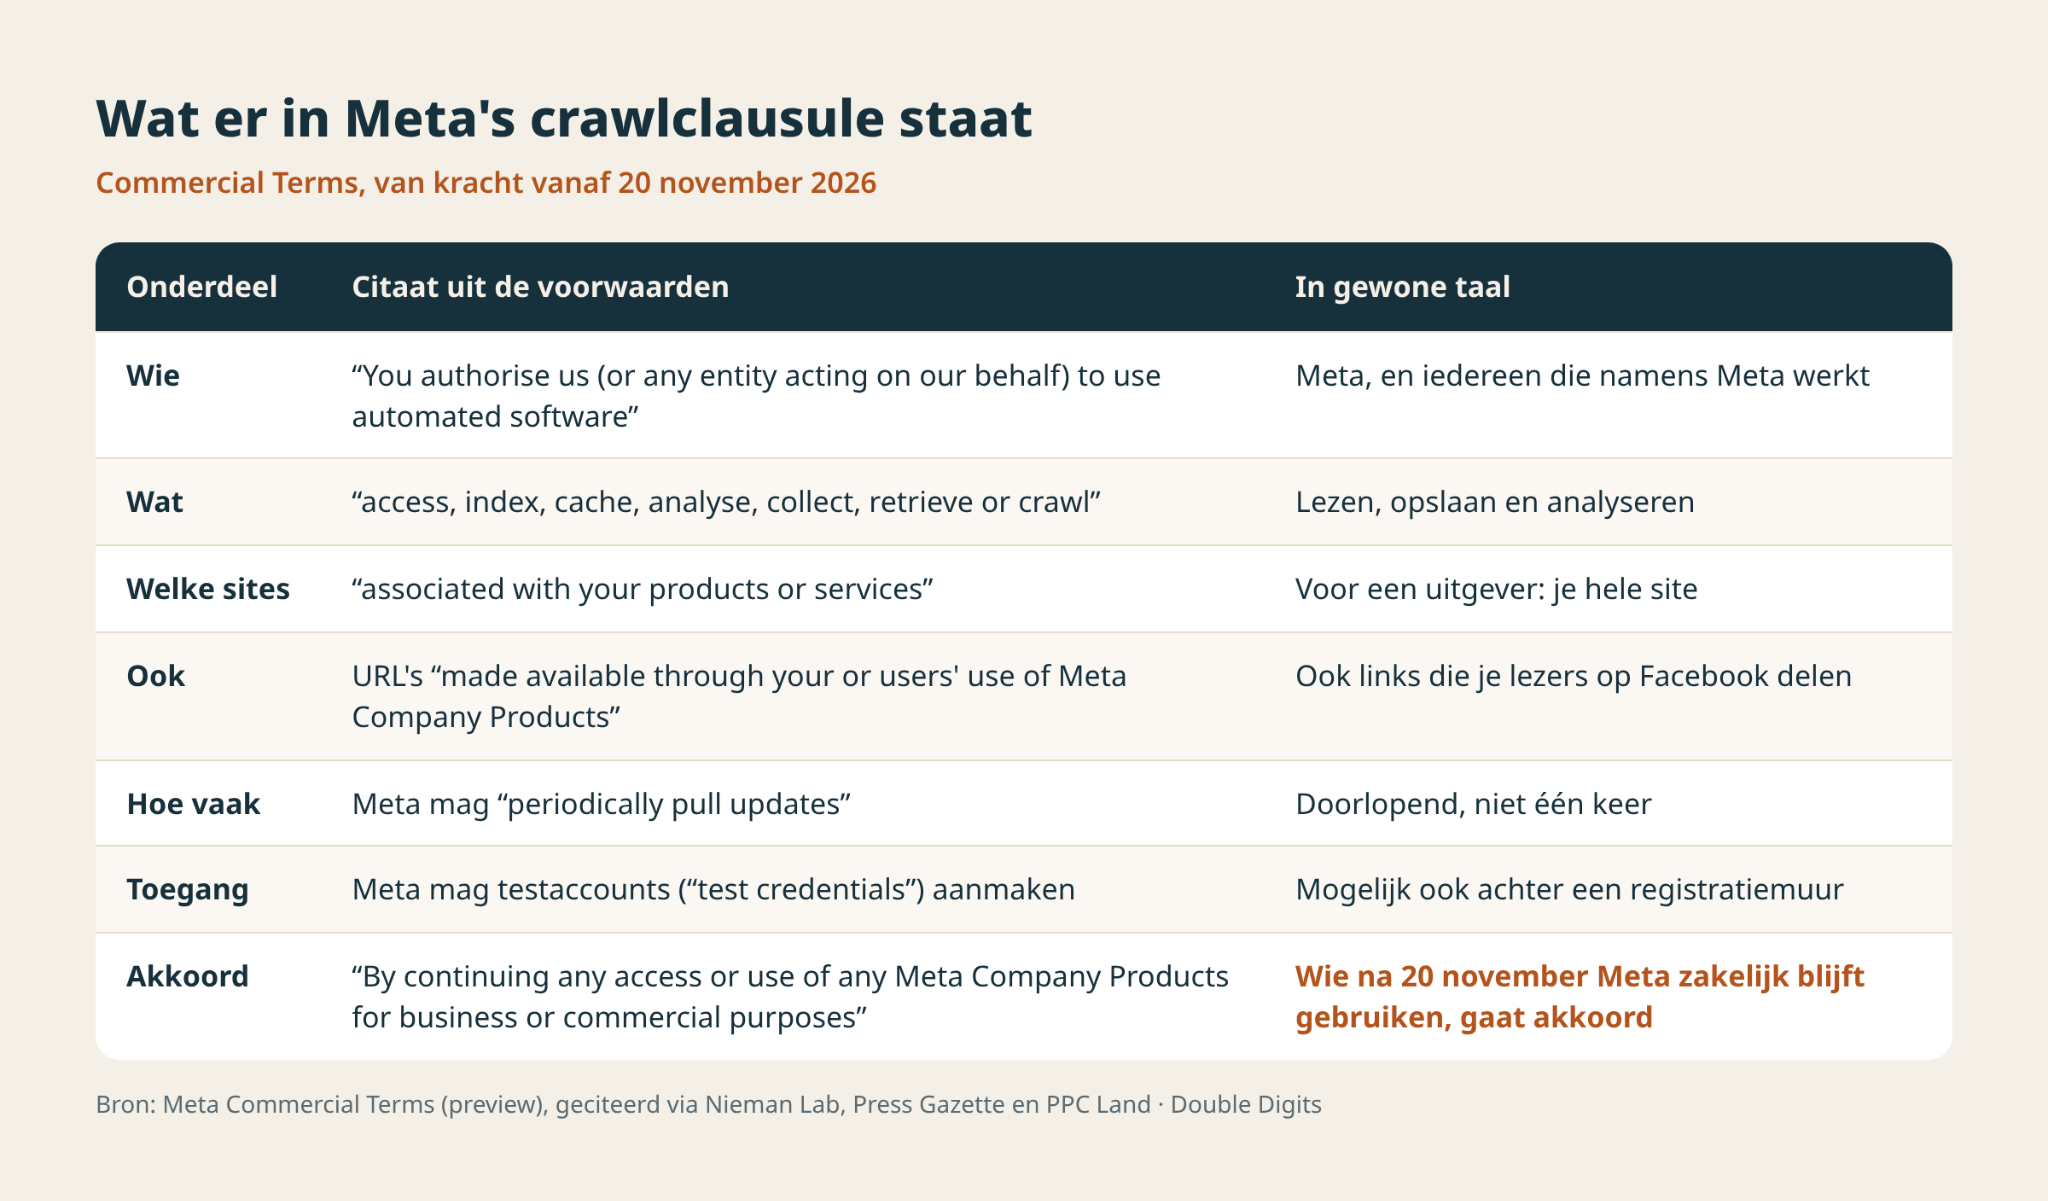
Citaten uit Meta’s voorwaarden (preview), via Nieman Lab, Press Gazette en PPC Land.
Na kritiek heeft Meta de tekst één keer aangepast. In de eerste versie mocht Meta je content gebruiken om te “train”. Op 16 oktober schrapte Meta dat woord en beperkte het gebruik tot “advertising and business products” (Search Engine Journal). Sinds 23 oktober is “train” ook uit de Britse versie verdwenen. Het woord “develop” staat er nog wel in: Meta mag crawlen om advertentie- en zakelijke producten te “provide, develop, improve, research and maintain” (PPC Land).
Wie valt eronder. Iedereen die Meta zakelijk gebruikt: een Facebook-pagina, een Instagram-bedrijfsaccount, Ads Manager, Business Suite of WhatsApp Business (Press Gazette). Je hoeft niets aan te klikken, en er is geen opt-out voor alleen de crawlclausule.
2. Wat betekent dit voor jou
Kort gezegd: Meta krijgt op papier toestemming om je journalistiek op te halen en te gebruiken, en jij levert mogelijk je juridische bescherming in. Vier gevolgen.
- Je hele site valt eronder, niet alleen wat je op Facebook zet. Het crawlrecht hangt aan je zakelijke account, niet aan je posts. Met testaccounts kan Meta volgens jurist James Grimmelmann (Cornell Law) ook achter een registratiemuur komen. Of dat ook voor een betaalmuur geldt, zei Meta niet (Nieman Lab).
- AI-gebruik is niet uitgesloten. “Train” is geschrapt, maar “develop” staat er nog, en “business products” wordt nergens gedefinieerd. Jurist Matt Topic vindt die formulering breed genoeg om AI-training te dekken (Nieman Lab). Meta’s AI-agent Muse is in de VS en Canada al gekoppeld aan advertentieaccounts en vijftien externe zakelijke tools (PPC Land). Mijn inschatting: als Meta zo’n AI-tool als “business product” ziet, sluit de huidige tekst niet uit dat je content daarvoor wordt gebruikt.
- Je voorbehoud tegen tekst- en datamining kan zwakker worden. In Nederland mag tekst- en datamining op je content, tenzij je dat uitdrukkelijk en machineleesbaar hebt voorbehouden (art. 15o Auteurswet). In de zaak DPG Media tegen HowardsHome zag de rechter de algemene voorwaarden van een website als machineleesbaar, mits het voorbehoud precies is. Dat is een uitspraak van een lagere rechter, geen vaste lijn (KVAN, april 2026). Met Meta’s voorwaarden geef je Meta echter zelf toestemming. Wat zwaarder weegt, je voorbehoud of die toestemming, heeft nog geen rechter beoordeeld. Topic en Grimmelmann waarschuwen dat Meta kan stellen dat het contract voorgaat op je robots.txt.
- robots.txt is een belofte, geen recht. Meta zegt dat robots.txt wordt gerespecteerd en dat het “not about scraping news sites” gaat (Press Gazette). Maar dat staat niet in de voorwaarden. Jurist Benjamin Sobel vergelijkt robots.txt met een bordje “Don’t look at my house”: naleving is vrijwillig. Twee crawlers van Meta kunnen robots.txt volgens Meta zelf omzeilen (Meta).
Wat nog onzeker is
- Hoe Meta zijn crawlers precies gaat inzetten. Meta heeft beloofd dat vóór 20 november uit te leggen.
- Of Meta de clausule in Nederland meteen na 20 november toepast. Zulke veranderingen worden vaak eerst zichtbaar in de VS, het VK of Australië.
- Of de Nederlandse versie van de voorwaarden “trainen” nog bevat.
- Hoe Meta reageert op uitgevers die zijn crawlers blokkeren. Mijn inschatting, niet op een bron gebaseerd: dat kan je bereik op Facebook en Instagram raken.
- Of je kunt weigeren zonder je zakelijke tools kwijt te raken. WAN-IFRA vroeg Meta daar op 22 oktober om, maar Meta is daar niet op ingegaan (The Keyword).
- Of Brussel ingrijpt. De European Publishers Council, de Britse News Media Association en de Amerikaanse News/Media Alliance reageerden op 16 oktober fel. EMMA, ENPA, EPC en NME dienden daarna samen een klacht in bij de Europese Commissie, en de Commissie verwelkomde het uitstel (PPC Land). Van NDP Nieuwsmedia vond ik tot en met 26 oktober geen reactie. In februari vroeg NDP met een coalitie wel om een kabinetsvisie op data in AI, maar een collectief dat dit met Meta oppakt is er in Nederland niet.
Niemand blokkeert de crawler waar het om draait
Ik heb gekeken wat tien grote Nederlandse nieuwssites nu tegenhouden. Bijna allemaal weren ze een deel van Meta’s crawlers. Maar geen enkele weert de crawler die Meta inzet voor advertenties en zakelijke producten, en daar gaan de nieuwe voorwaarden juist over.
- 0 van 10 blokkeert Meta’s advertentiecrawler.
- 6 van 10 blokkeert Meta’s AI-crawler. Het AD, de Volkskrant, Trouw en Het Parool laten hem toe, terwijl ze wel tientallen andere AI-bots weren.
- Niemand is voorbereid op het contract zelf. Een blokkade houdt een crawler tegen, maar niet de toestemming die je geeft als je Meta’s voorwaarden accepteert. Daarvoor is stap 2 hieronder.
De volledige check per site staat onderaan, bij „Voor je developer”.
3. Wat kun je doen
Geen enkele optie beschermt zowel je content als je bereik via Meta volledig. Mijn advies: verzamel eerst data en leg je juridische voorbehoud goed vast. Besluit pas daarna of je crawlers blokkeert of accounts opheft. Door het uitstel heb je daar tot 20 november de tijd voor.
Stap 1. Meet wat Meta’s crawlers doen
Laat je developer vastleggen hoe vaak Meta’s crawlers je site nu bezoeken, welke secties ze lezen en of ze achter je betaalmuur komen. Dat is je nulmeting.
- Herhaal de meting na 20 november. Dan zie je of Meta meer gaat ophalen.
- Let op: een besluit om te vertrekken (stap 5) moet vóór 20 november vallen. Dat besluit neem je dus op basis van deze nulmeting en wat Meta vóór die datum uitlegt, niet op basis van de meting erna.
Stap 2. Leg je voorbehoud vast
Daarmee dek je je juridisch zo goed mogelijk in, wat je verder ook met Meta doet.
- Neem een expliciet voorbehoud tegen tekst- en datamining op in je algemene voorwaarden, en noem AI-training daarin met zoveel woorden. Het KVAN raadt een losse zin in de footer af.
- Laat je developer het voorbehoud ook machineleesbaar maken (zie hieronder).
- Leg je jurist één vraag voor: gaat acceptatie van Meta’s Commercial Terms boven ons voorbehoud?
Stap 3. Meta’s crawlers uitsluiten (ik zou eerst de data afwachten)
Je kunt een deel van Meta’s crawlers weren. Ik raad dat nu nog niet aan, omdat nog niemand weet hoe Meta erop reageert. Wil je het toch, begin dan met de twee crawlers die het veiligst te blokkeren zijn: die voor AI-modellen en die voor advertentieproducten (zie „Voor je developer”). Bij die laatste zou je voorop lopen: van de tien grote nieuwssites blokkeert nu niemand hem. Adverteer je zelf via Meta, check dan eerst met je marketingteam of het hun campagnes raakt. Laat de crawler voor linkpreviews staan, anders verdwijnen de previews bij links die lezers op Facebook delen.
Blokkeren beschermt je content, maar verandert niets aan wat je in het contract hebt geaccepteerd. Daarvoor is stap 2 bedoeld.
Stap 4. Laat je horen via de branche
Steven Wilson-Beales noemde aansluiten bij een collectief de belangrijkste route. In Nederland bestaat geen collectief dat dit met Meta oppakt: het Google-akkoord via Stichting OPR dekt geen AI (The News Stack).
Stap 5. Je zakelijke Meta-accounts verwijderen (zou ik niet snel doen)
Volgens de voorwaarden ga je akkoord zodra je Meta zakelijk blijft gebruiken. Stoppen met dat gebruik is dus de enige manier die de voorwaarden zelf bieden om niet akkoord te gaan. Voor de meeste uitgevers is Meta daarvoor echter een te belangrijk kanaal.
- Reken eerst uit wat Meta je oplevert: het aandeel in sessies en nieuwe abonnees, plus je advertentieomzet via Meta.
- Wil je toch weg, doe het dan voor 20 november. Het gaat om Facebook-pagina’s, Instagram-bedrijfsaccounts, Ads Manager, Business Suite en WhatsApp Business.
Voor je developer
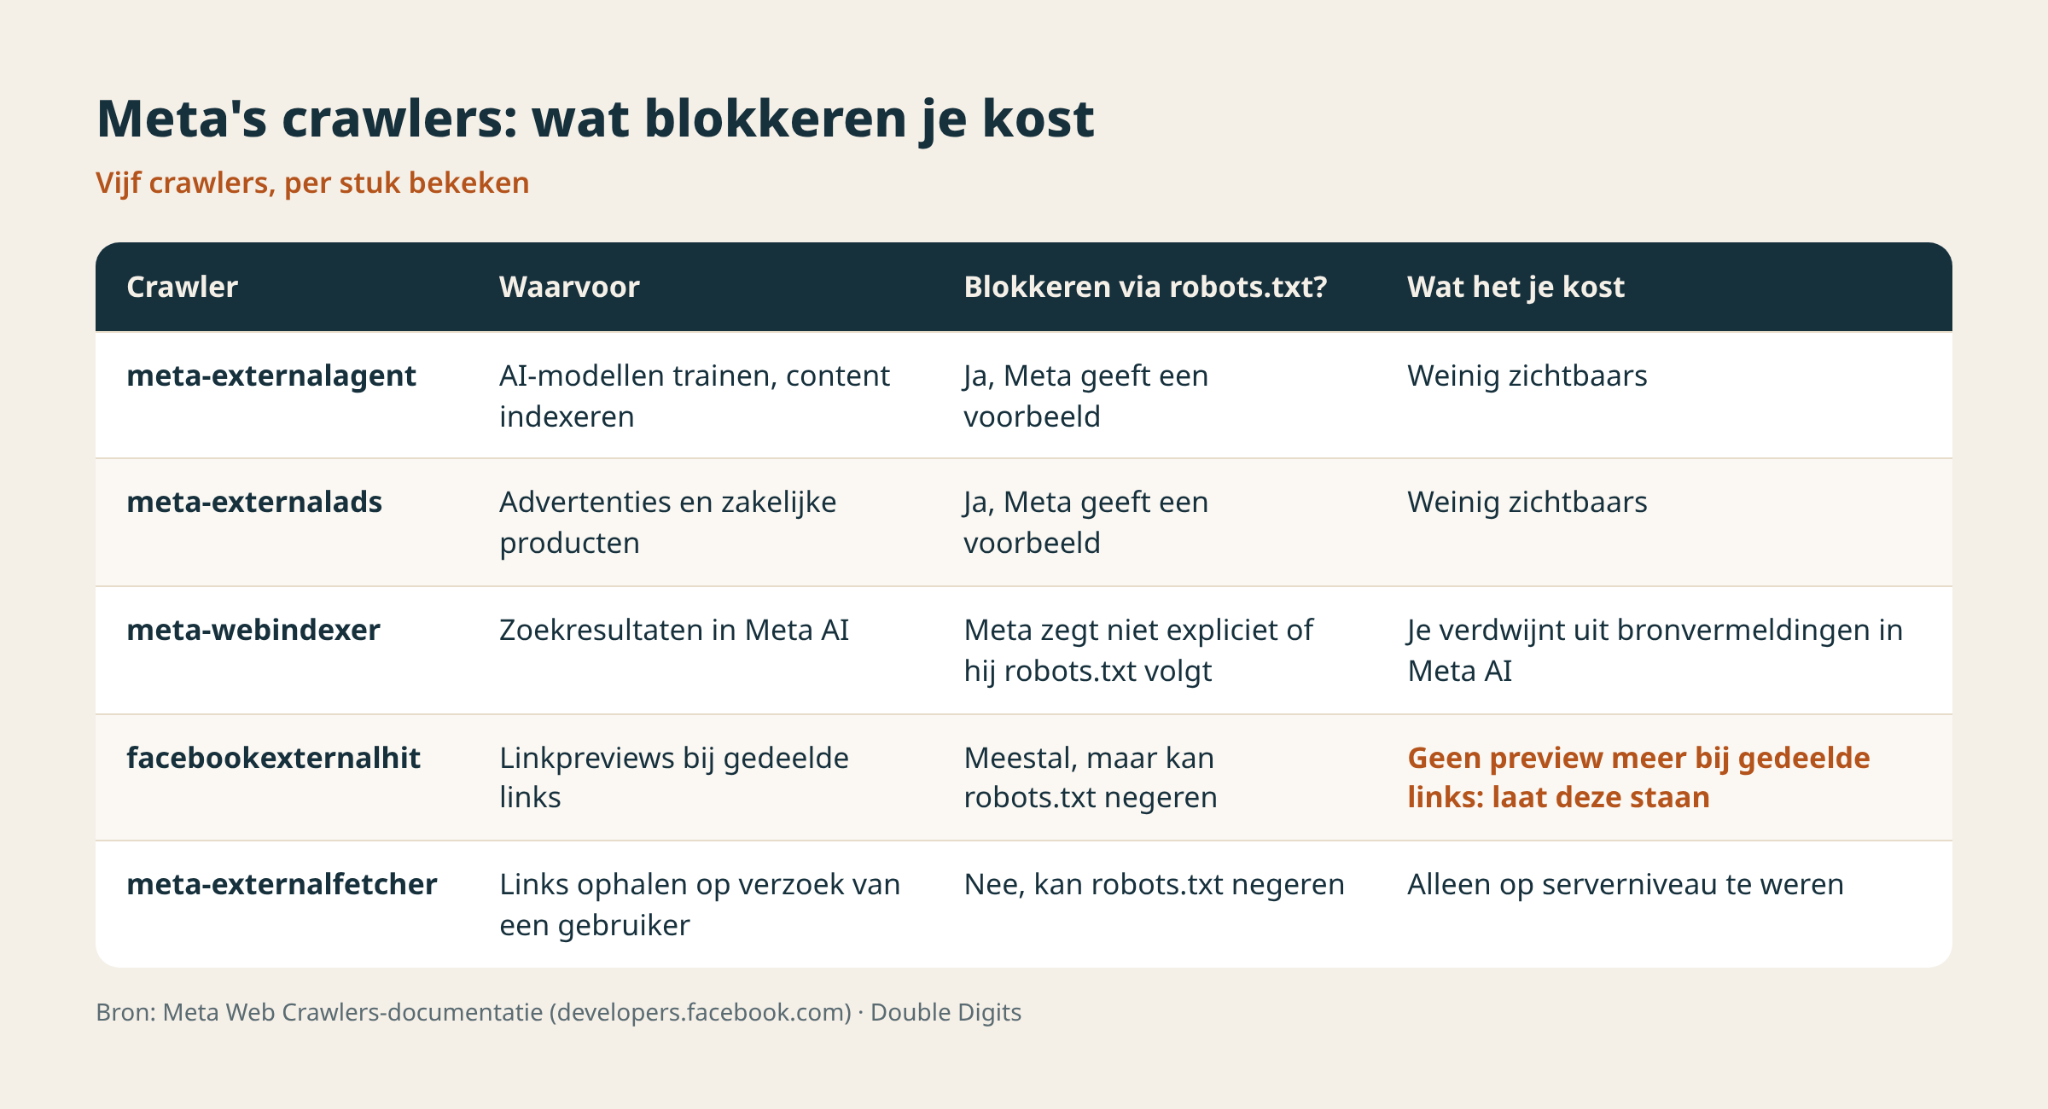
Meten. Filter je serverlogs of CDN-logs op meta-externalagent, meta-externalads, meta-webindexer, facebookexternalhit en meta-externalfetcher. Leg per crawler vast: het aantal verzoeken, de secties en of hij achter de betaalmuur komt.
Machineleesbaar voorbehoud. Voeg naast robots.txt ook TDMRep toe (/.well-known/tdmrep.json). Het KVAN adviseert beide, omdat TDMRep nog in ontwikkeling is.
Crawlers per stuk (Meta’s crawlerdocumentatie):
De twee veiligste blokkades:
User-agent: meta-externalagent
Disallow: /

User-agent: meta-externalads
Disallow: /
Volgens Meta kan het tot 24 uur duren voordat de crawlers een gewijzigde robots.txt oppikken. Blokkeren op serverniveau werkt ook bij crawlers die robots.txt negeren, maar een user agent is na te bootsen, en Meta publiceert geen IP-reeksen.
Robots.txt-check bij tien nieuwssites (26 oktober 2026; „Ja” = Disallow: / voor die crawler):
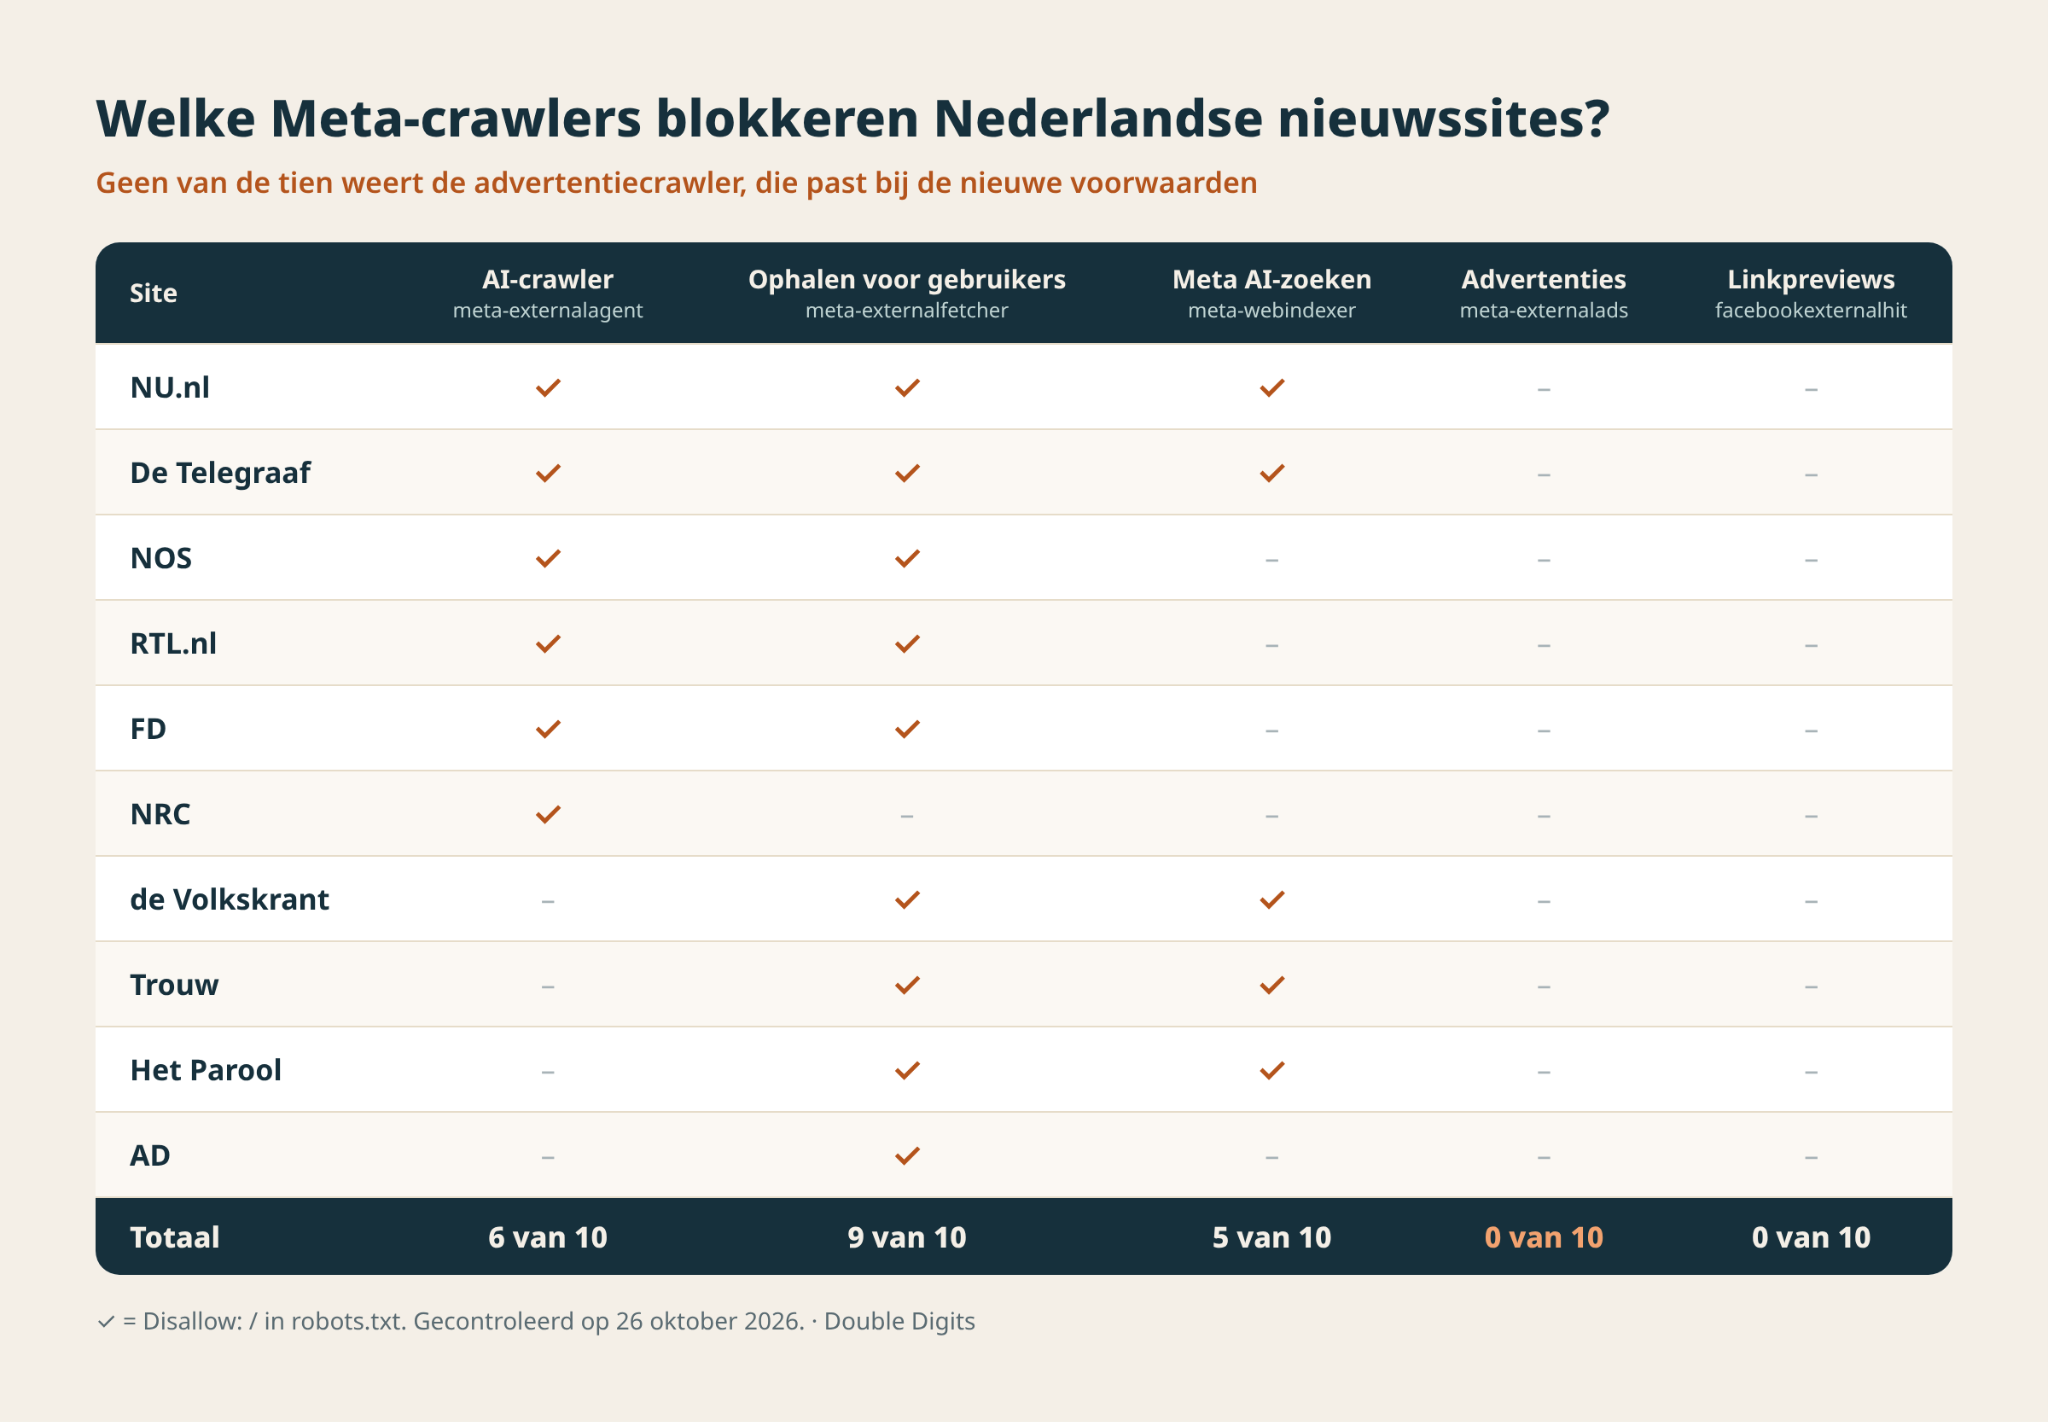
De voorwaarden noemen geen specifieke crawler, dus Meta zit niet vast aan meta-externalads. Dat niemand hem blokkeert, kan een bewuste keuze zijn van uitgevers die zelf via Meta adverteren; dat is mijn inschatting.
Kijk je naar het voorbehoud tegen tekst- en datamining in robots.txt, dan is FD het verst: het verwijst als enige naar TDMRep en een AI-beleid. De Telegraaf en NRC noemen tekst- en datamining en AI met zoveel woorden. De DPG-titels en RTL.nl hebben een algemener verbod op scraping; de NOS heeft geen voorbehoud in robots.txt. Ik heb alleen robots.txt bekeken, niet de algemene voorwaarden, en een blokkade op serverniveau zie je daar niet in.
Hoe wij hiermee omgaan
Dit soort wijzigingen komt vaker voor, bij Meta, bij Google en bij AI-bedrijven. Voor de uitgevers met wie we werken, volgen we ze en zoeken we uit wat ze betekenen voor bereik en rechten. Daarna zetten we de keuze klaar, met de juiste mensen aan tafel: redactie, development, legal en directie. Het juridische oordeel laten we bij je eigen jurist.
Op de hoogte blijven van de laatste ontwikkelingen binnen de publisher wereld? Schrijf je dan in voor de Publisher Brief nieuwsbrief